工程 · 2026.10.01 · 5 min · 更新於 2026.10.26
GitHub Actions 加速 Rust 與 Next.js 的 CI:11 分半壓到 1 分半
後端換成 Rust 後,PR 的 backend job 從 11 分半壓到 1 分半,前端檢查從 81 秒壓到 30 秒。時間主要省在測試 DB、bcrypt 和幾個讓快取無聲失效的 bug。
閱讀設定
Rust 後端第一次在 GitHub Actions 跑 CI,backend job 跑了 11 分半,最後還因為磁碟滿而失敗。
後來壓到 1 分 33 秒,前端檢查也從 81 秒變成 30 秒。時間主要省在三個地方:測試打 Postgres 的方式、測試裡的 bcrypt,還有幾個讓快取無聲失效的 bug。
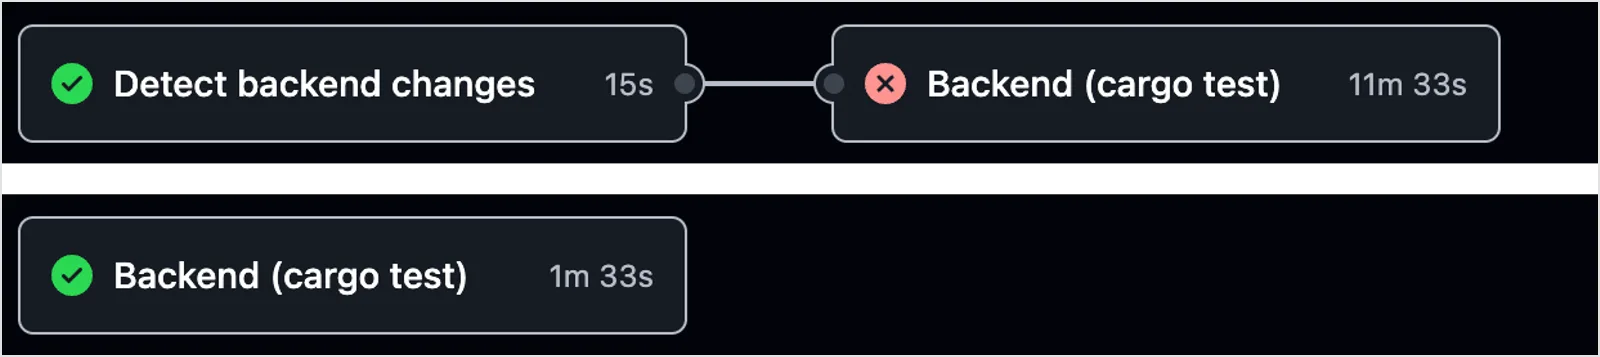 上面是第一次跑的 11 分 33 秒(失敗),下面是 arm64 熱快取的 1 分 33 秒。
這是後端從 Java Spring Boot 遷移到 Rust之後的第一個 PR。條件是私有 repo、每月 2,000 分鐘的 Actions 額度、後端單一 crate、GitHub 的標準 runner。
先量 2 vCPU runner 的時間
私有 repo 的標準 runner 是 2 vCPU。跟 M 系列 Mac 比,編譯慢約 2.2 倍,Postgres 類的工作慢約 4 倍。
本機跑得快的東西,到 CI 上會被放大好幾倍。
第一次那 11 分半裡,下載 crate 只佔 3 秒,大頭是沒有快取的冷編譯和 DROP DATABASE。
不量,根本猜不到。
Postgres 和 bcrypt
Rust 的 repository 沒有 DI(依賴注入,測試時可以把資料庫換成假的),所以測試幾乎都打真的 Postgres。
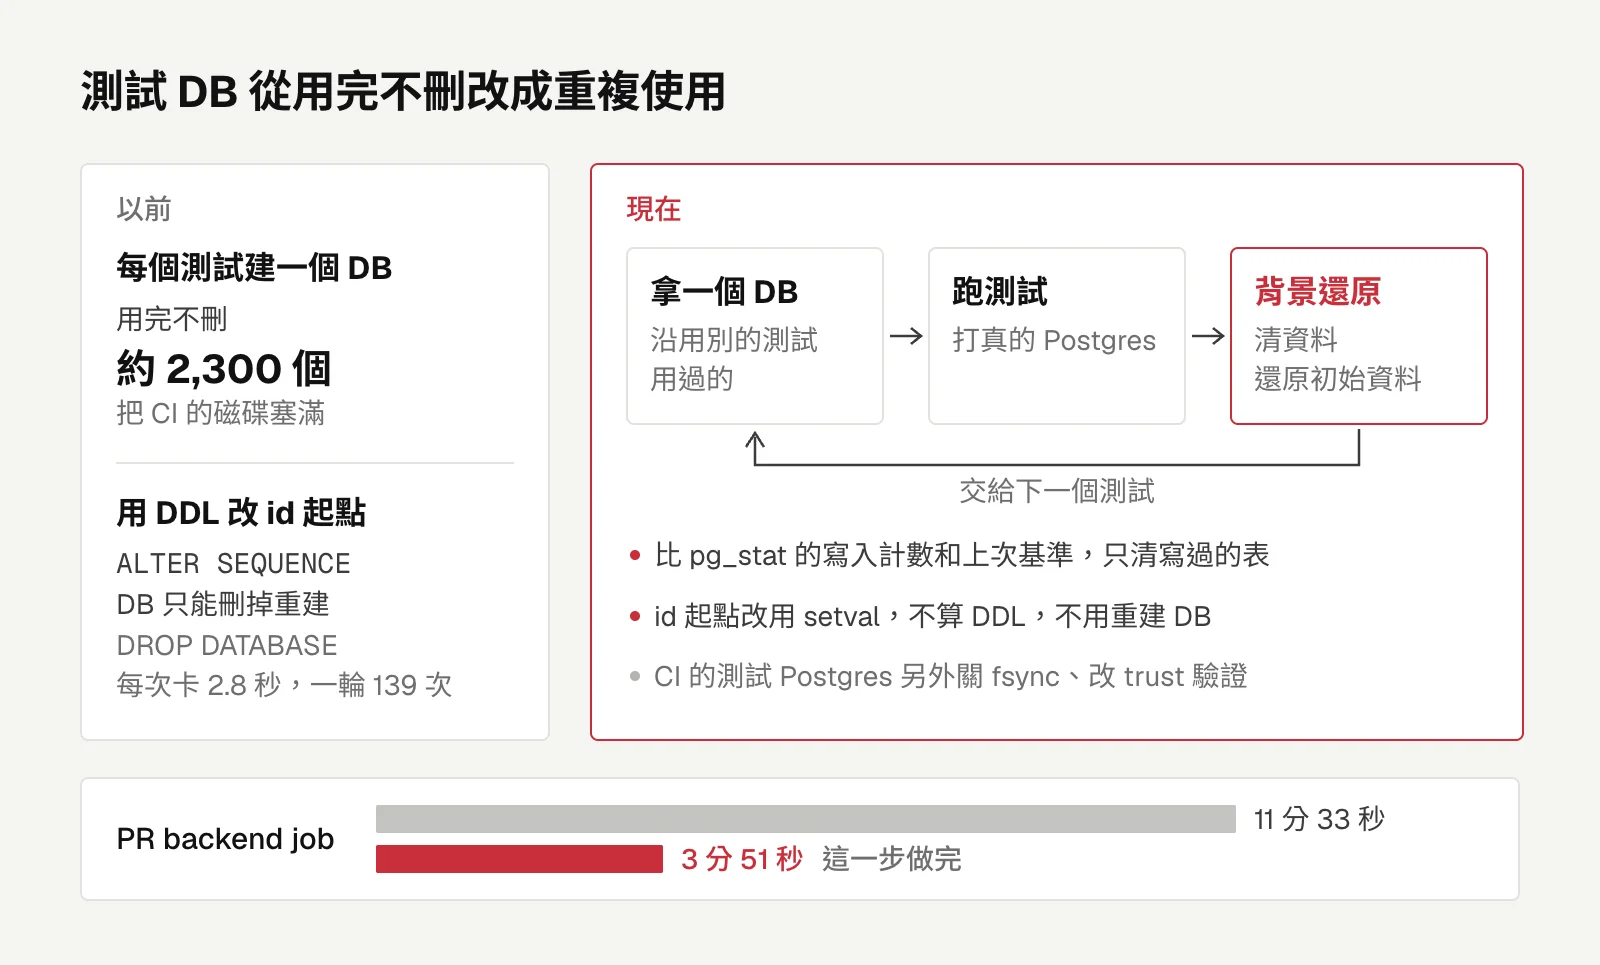
測試 DB 原本是每個測試建一個、用完不刪,CI 上累積到約 2,300 個,把磁碟塞滿。我改成重複使用:測試結束後在背景清資料、還原初始資料,再交給下一個測試。
還原時不用每張表都清。Postgres 的 pg_stat 統計記著每張表 insert、update、delete 的累計數,跟上次還原後的基準一比,就知道上一個測試寫過哪些表。
另外有兩個 helper 用 ALTER SEQUENCE ... RESTART 改 id 起點,這是 DDL(改結構的指令),DB 只能刪掉重建,每次 DROP DATABASE 卡 2.8 秒,一輪 139 次。改用 setval 效果一樣,而且不算 DDL。
CI 上的測試 Postgres 再關掉 fsync、改成 trust 驗證。這一步做完,11 分 33 秒降到 3 分 51 秒。
接著看 CPU,測試程式的時間有六成以上花在 bcrypt。
註冊、登入的測試都走正式流程,每次都算 cost 12。我在測試裡改成 cost 5,另外留一個測試守住正式環境還是 12。
連線也改成每個測試 DB 保留常駐連線,每個測試平均開的連線從約 3.3 條降到 1.4 條。
GitHub Actions 快取的坑
做到這裡,熱快取的 PR job 中位數約 2.6 分。但 25 次 run 裡有 6 次是冷的,要 7.5 到 12 分。
我拿同樣有 Postgres 的知名 Rust 專案比過,設定本身已經在前段,慢的是幾個 bug。
第一個是半套快取佔住 key。rust-cache 的 cache-on-failure 讓一次被取消的 run 存了一份 72MB、幾乎是空的快取。GitHub 的快取存進去就不能改:
You cannot change the contents of an existing cache. Instead, you can create a new cache with a new key.
出自 GitHub Actions 的 dependency caching 文件。結果就是之後每次 run 都精準命中這份空快取,又不重存,等於每次冷編,而且不會自己好。
第二個是冷編譯太頻繁。toolchain 沒釘版本,stable 出新版那天所有 run 都冷編。vendor 的 sqlx-postgres 內容 hash 放在快取 key 裡,改一次 vendor,三百多個依賴全部重編。版本改釘在 rust-toolchain.toml,vendor 改用 option_env!,讓 cargo 只重編那一條。
第三個是規則改了不會通知你。cargo 1.99 起,只要有 CI 環境變數就預設關掉 incremental,加速會在升級那天無聲失效。所以編譯改走一支 wrapper,把 CI 拿掉。
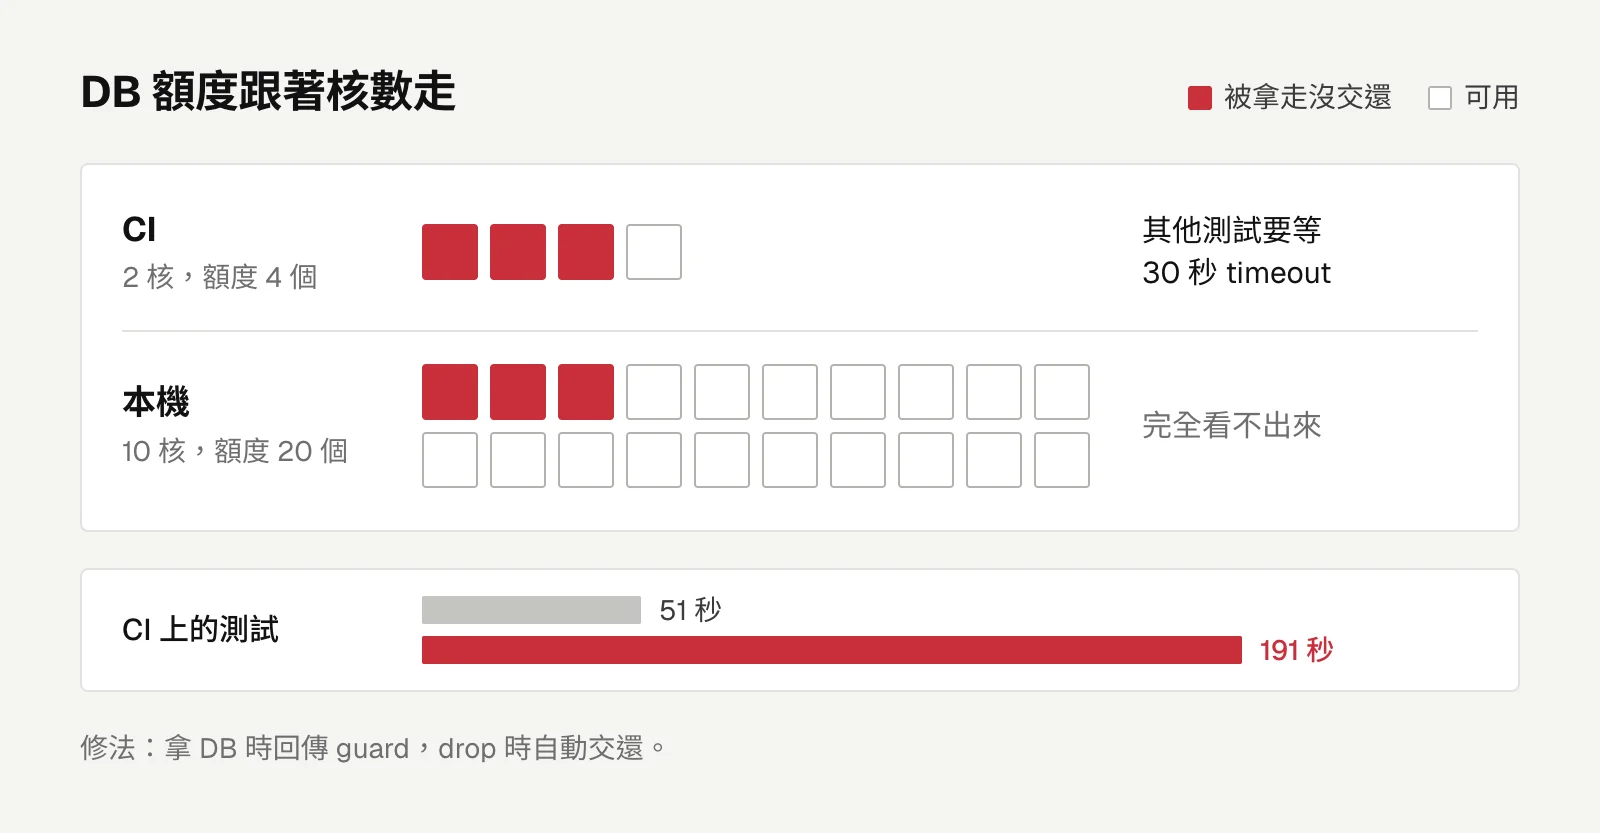
第四個是資源額度跟核數掛鉤。一個新測試拿了 DB 不交還。DB 額度是平行測試數的兩倍,2 核的 CI 只有 4 個,被佔掉 3 個之後,其他測試要等 30 秒 timeout,測試時間從 51 秒變成 191 秒。
本機 10 核、額度 20 個,完全看不出來。
我改成拿 DB 時回傳 guard,drop 時自動交還。
incremental 快取的 key 也從 commit SHA 改成看內容(toolchain 版本加 backend/ 的 git tree)。後端沒變就不重存,快取總量從 11.4GB 降到約 2GB。
前端檢查:81 秒到 30 秒
前端的時間主要在 next build 28 秒和 ESLint 18 秒,有兩件事是查下去才知道的。
ESLint 的時間八成多花在 React Compiler 那組規則上,而 Next 16 拿掉 next lint 之後,原本內建的快取也跟著沒了。next build 內建的型別檢查吃不到 incremental,每次都等於從頭來。
改法是 ESLint 開 --cache、放到背景跟 build 同時跑,再開 Turbopack 的 build 檔案快取。型別檢查拆成獨立步驟,改用原生版的 TypeScript 7,整包冷跑 2 到 3 秒。命中快取時直接還原 node_modules,不跑 npm ci。
Turbopack 的檔案快取還在 experimental,所以只有 PR 讀它,main 每次都冷編,要上 STG 的產物不靠快取。
前後對照與沒做的事
| 項目 | 優化前 | 優化後 |
|---|---|---|
| PR backend job | 11 分 33 秒 | 1 分 33 秒(熱快取、arm64) |
| 其中測試 | 196 秒 | 33 到 36 秒 |
| merge 到 STG | 約 7.5 分 | 約 4 分 10 秒 |
| Actions 快取總量 | 11.4GB | 約 2GB |
| PR 前端檢查 | 81 秒 | 約 30 秒 |
最後一步是換 arm64 runner。它的 2 vCPU 是 2 顆實體核,x64 是 1 核開 SMT,吃滿兩核的 DB 測試從 42.7 秒變成 33.3 秒,單價也比較低。
拆成多個 crate 是我一開始想走的方向。用 Java 時期 250 個 commit 模擬,照模組直接切,平均編譯量只降到 0.96 倍;換一種切法,甚至變成 1.20 倍。原因是最常改的模組,同時也是被最多模組依賴的。
自架 runner 也評估過,手上閒置的 4 核 ARM 機器跑增量編譯反而比較慢,還要自己維運。
nextest、mold、拆 crate 這些網路上常見的加速法,在單一 crate、2 vCPU 的條件下多半用不上,它們靠的是多核和多個 test binary。這次真正有用的,是先量 CPU 花在哪,以及讓快取 key 跟著內容走、不跟著 commit SHA 走。
工程
量化交易虧損時該不該改策略?把檢討流程寫成程式,13 種降風險改法都沒過關
把「持續虧損就重新評估」事先寫成觸發條件和判定順序,第一次自動觸發先抓到檢討程式自己的兩個 bug,13 種降風險改法也沒有一個通過事先訂好的標準。
留言
載入留言中…